- 01 / 15
Permissions et confidentialité
Limite chaque utilisateur, projet et agent aux outils, pipelines et ressources dont il a besoin, pour un accès à privilège minimal. Les identifiants des connecteurs sont chiffrés au repos et atteignent les runs de pipeline via des handles à usage unique. La sécurité au niveau des lignes garde les comptes séparés. Les agents d’appareil ne touchent que les apps et sites que tu autorises. Les payloads d’événements et la mémoire stockée sont traités comme des données non fiables pour limiter l’injection de prompt. Le masquage de confidentialité Sether et le scan d’actions Koreshield sont optionnels, par agent ou par chat.
- 02 / 15
Validation humaine
Les validations humaines (human-in-the-loop) pour agents IA mettent en pause les actions que tu choisis avant qu’elles s’exécutent. Le mode sûr est la valeur par défaut, et l’autonomie est un réglage que tu actives. Approuve, refuse ou modifie les arguments depuis une seule feuille de validations, sur ordinateur ou téléphone. Chaque décision est enregistrée avec son run. Les actions navigateur et ordinateur sont filtrées par type d’effet, les validations sur les runs déclenchés expirent, et un bouton d’arrêt termine un run.
- 03 / 15
Évaluations et preuves
L’évaluation des agents regarde les preuves, pas seulement la réponse finale. Melaya inspecte chaque résultat d’outil à la recherche d’erreurs d’authentification, de données vides, d’écritures non confirmées et de réponses qui déclarent une source indisponible alors qu’elle a renvoyé des données. Des contrôles optionnels couvrent le schéma de sortie, le grounding et les citations. Le mode observation note les runs sur un dashboard. Le mode application relance avec une note de correction, jusqu’à une limite fixée. Un juge LLM optionnel peut rejeter une réponse, mais n’en approuve jamais une seule.
- 04 / 15
Traces et observabilité
Chaque run reçoit un ID, une vue en direct et un historique conservé. Le traçage LLM enregistre des spans OpenTelemetry pour les appels aux modèles et aux outils, avec latence, entrées, sorties et comptage de tokens. Un registre d’audit des appels d’outils montre quel agent a appelé chaque outil, quel modèle l’a demandé et qui l’a approuvé, disponible via la REST API. Le suivi du coût par token tarife chaque appel. Les motifs de secrets connus sont masqués avant stockage, et l’accès suit l’appartenance au projet.
- 05 / 15
Fiabilité et reprise
Les guardrails vérifient chaque appel d’outil avant son exécution. Melaya valide les arguments contre le schéma de l’outil, corrige les écarts de type sûrs et renvoie une erreur claire pour que l’agent puisse réparer son propre appel. Les timeouts, les retries avec backoff et les circuit breakers absorbent les API instables et les rate limits. Les actions d’écriture s’exécutent une par une, les résultats surdimensionnés sortent de la fenêtre de contexte, et chaque boucle d’agent a une limite d’étapes.
- 06 / 15
Planification et événements
Fais tourner des agents IA planifiés sur un cron, dans ton fuseau horaire, ou démarre-les depuis des événements. Melaya reçoit des webhooks signés, des abonnements push sur les apps connectées, des flux WebSocket et SSE, et effectue du polling en repli. Des filtres optionnels et des questions à Laya décident si un événement compte. Chaque événement fait alors une seule chose : te notifier, appeler un outil, réveiller un crew en cours ou démarrer un pipeline. Chaque livraison laisse un reçu.
- 07 / 15
Orchestration des agents
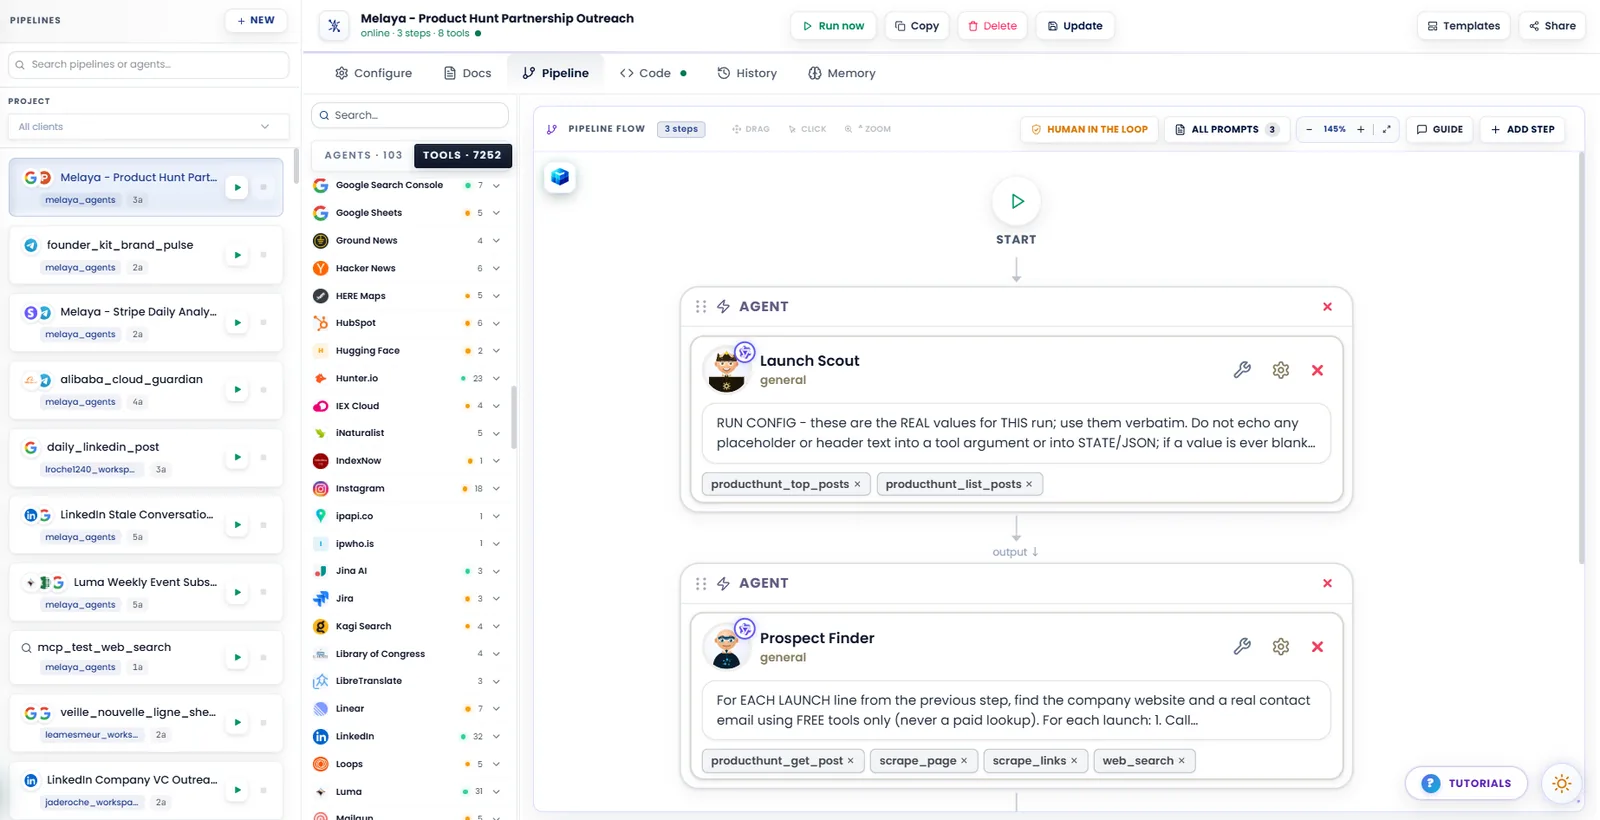
Orchestration multi-agent sur un canvas visuel. Fais tourner des agents IA en séquence ou en parallèle, branche sur la sortie d’un agent, répète une étape dans une boucle bornée, ou dessine un graphe qui route le travail entre les étapes. Pars de crews réutilisables d’agents prédéfinis pour la recherche, la finance, la vente, le juridique, les RH et les opérations. Dans le Melaya Assistant, un agent principal peut confier une sous-tâche à un sous-agent spécialiste.
- 08 / 15
Instructions et entrées
Donne à chaque agent IA un rôle, un system prompt et une instruction de tâche, ou pars d’une persona prédéfinie ou d’un template de pipeline que ton équipe peut partager. Décris un objectif en langage simple et Build with AI rédige le workflow multi-agent. Chaque run peut recevoir un brief et des fichiers joints comme des PDF et des feuilles de calcul. Melaya génère et valide le code du pipeline sur le serveur avant de l’exécuter.
- 09 / 15
Laya · System One
Laya est un modèle System One à poids ouverts que Melaya héberge. Il répond à des questions typées de choix, de score et de oui-ou-non, avec une confiance calibrée et sans texte généré. Les agents l’utilisent pour classifier ou classer de nombreux éléments en un seul appel, filtrer les déclencheurs d’événements et exécuter des étapes de décision dans les pipelines. En mode rapide navigateur, téléphone et ordinateur, c’est un repli restreint pour les cibles ambiguës. Ton modèle IA principal continue de planifier.
- 10 / 15
Outils et intégrations
Donne à chaque agent IA seulement les outils dont il a besoin, choisis dans un large catalogue d’outils typés et de connecteurs API pour l’email, les CRM, les feuilles de calcul, les bases de données, les paiements, les réseaux sociaux et le web. Connecte tes apps métier avec OAuth ou une clé API, gardée chiffrée. L’Assistant charge des outils supplémentaires à la demande pour garder les prompts légers. Melaya fait tourner un serveur MCP distant, afin que Claude, ChatGPT, Cursor et d’autres clients MCP puissent exécuter tes pipelines avec des permissions limitées.
- 11 / 15
Appareils et utilisation de l’ordinateur
Utilisation de l’ordinateur par l’IA, avec une boucle de sécurité. Les agents pilotent un vrai navigateur web, un téléphone Android et les applications de bureau de ton propre ordinateur. Chaque étape suit lire, agir, vérifier : lis la page ou l’arbre d’accessibilité, agis sur un élément nommé, puis confirme le changement. Le mode rapide exécute plusieurs étapes planifiées par appel au modèle. Les allowlists d’applications et de sites, les validations et un bouton d’arrêt couvrent chaque appareil.
- 12 / 15
Mémoire et contexte
Melaya garde la mémoire de l’agent dans la fenêtre de contexte de chaque modèle. La mémoire de travail compacte les anciens tours en résumé, et les longs résultats d’outils sont paginés plutôt que coupés. La mémoire persistante entre runs est optionnelle par pipeline : les agents gardent les leçons et les échecs d’outils pour le prochain run, limités par agent, avec les secrets masqués. Tu peux revoir, modifier ou supprimer chaque entrée. L’Assistant garde sa propre mémoire de conversation.
- 13 / 15
Connaissances et recherche
Ancre tes agents IA dans tes propres fichiers PDF, Word, Excel et PowerPoint. Les documents courts passent directement dans le prompt, et les longs sont découpés en plan puis lus page par page. Pour les grandes collections, active le mode recherche : Melaya indexe les fichiers dans une base vectorielle et les agents les cherchent avec RAG. Connecte des coffres Obsidian depuis ton ordinateur, un envoi de fichier ou un dépôt Git, et choisis par agent la connaissance qu’il voit.
- 14 / 15
Modèles et fournisseurs
Melaya fonctionne avec le modèle que tu apportes. Choisis le LLM de chaque agent IA parmi OpenAI, Anthropic, Google Gemini, Mistral, DeepSeek, Qwen et des dizaines d’autres fournisseurs, ou passe par OpenRouter, LiteLLM et d’autres gateways. Fais tourner des modèles à poids ouverts en local avec Ollama ou LM Studio, utilise ton abonnement Claude Code, Codex ou GitHub Copilot via le runner local, ou pointe vers n’importe quel endpoint compatible OpenAI. Mélange les modèles dans un même pipeline.
- 15 / 15
Exécution et budgets
Les runs s’exécutent dans un sandbox cloud isolé ou sur un runner auto-hébergé, sur ton propre ordinateur ou serveur. Les pipelines qui ont besoin de modèles locaux ou de tes sessions connectées tournent sur le runner. Les runs cloud sont dimensionnés selon leurs outils et mis en file quand la capacité est chargée. Des plafonds de coût optionnels par pipeline ou par agent alertent à 80% et arrêtent le run à la limite. Les offres fixent les quotas de runs, la concurrence et la fréquence de planification.
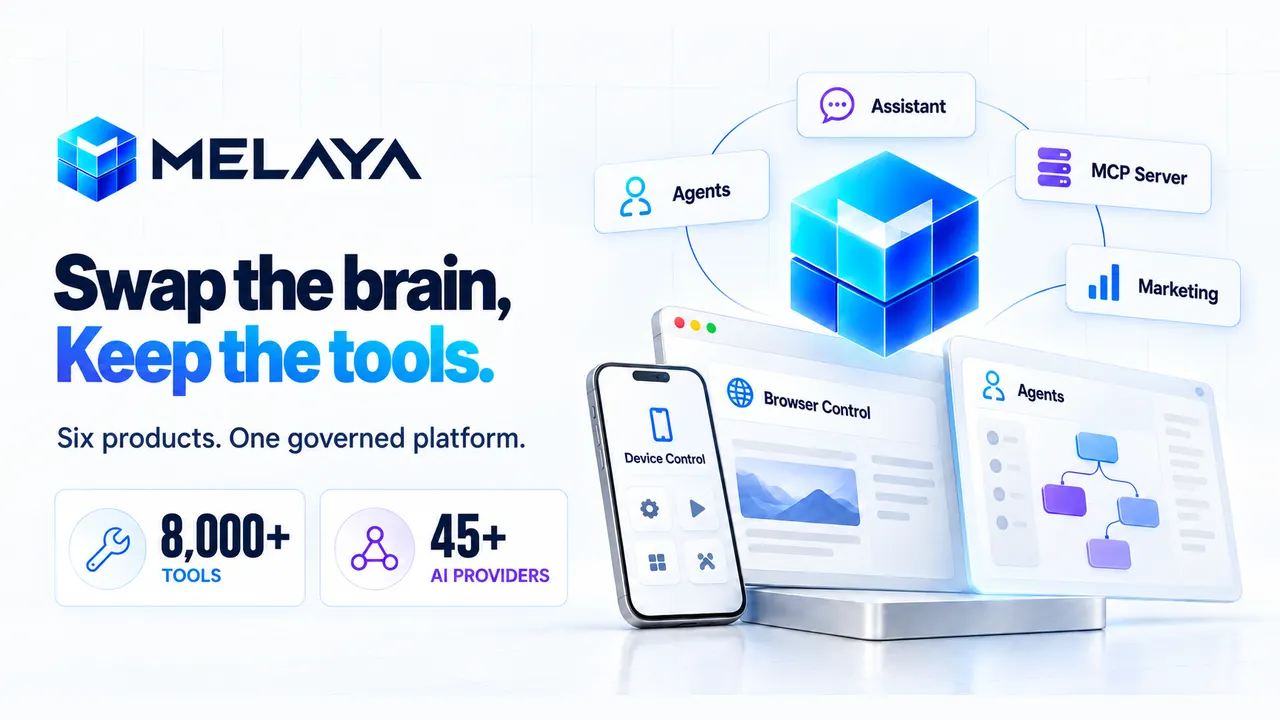
Une carte des capacités de Melaya. Leur disponibilité dépend du produit, de l’offre et de la configuration. Les protections optionnelles, la mémoire persistante et les corrections guidées par les évaluations doivent être activées.
 Agents
 Assistant
 Device Control
 Browser Control
 Computer Control
 MCP Server
 Marketing

 Melaya Assistant

 Melaya MCP
 mailchimp · campaign report
 github · read pull requests
 also on Telegram